當執行VMware時, 偶發一次發生出現這樣的訊息, "The Virtual Machine appears to be in use..."
其guest os再也無法開機, 原來它會建立lock file or lock path,
一旦偵測有其lock file path存在, 便不會讓相同的guest os重覆執行, 是種保護機制,
所以依照下述步驟, 便可解除這樣的問題:
1. 進入virtual machine安裝guest os的資料夾
2. 將*.lck的資料夾, 重新更名為其它名稱, 亦或者將它們刪除
3. 重新啟動guest os
2010年2月18日 星期四

2010年2月13日 星期六
調整TCP TIME_WAIT, 快速釋放連線資料
在參閱TCP TIME_WAIT的釋義一文後,
了解到系統須等待2MSL時間, 才進入CLOSED狀態, 關閉連線
在linux RedHat AS4中, 執行$>netstat -tnao, 會發現到,
主動斷線端處理TIME_WAIT後, 須等待60秒, 才會真正關閉連線
哪有什麼方式可以縮短TIME_WAIT的等待時間呢??
方法一.
$> vi /etc/sysctl.conf
## 表示開啟重用機制, 允許socket在TIME_WAIT狀態下, 重新bind新的socket
net.ipv4.tcp_tw_reuse = 1
## 表示開啟回收機制, 允許socket在TIME_WAIT狀態下, 被快速回收, 毋須等待2MSL
net.ipv4.tcp_tw_recycle = 1
$> /sbin/sysctl -p ## 使上述設定生效
方法二.
## 查看系統預設TIME_WAIT時間
$> more /proc/sys/net/ipv4/tcp_fin_timeout
## 修改系統預設TIME_WAIT時間
$> echo 30 > /proc/sys/net/ipv4/tcp_fin_timeout
方法三.
在setsockopt()時, 設置SO_LINGER之屬性,
linger.l_onoff 表示開啟延遲功能
linger.l_linger 表示延遲時間為0秒
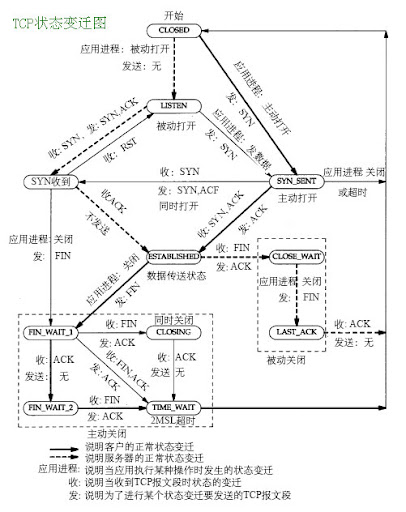
了解到系統須等待2MSL時間, 才進入CLOSED狀態, 關閉連線
在linux RedHat AS4中, 執行$>netstat -tnao, 會發現到,
主動斷線端處理TIME_WAIT後, 須等待60秒, 才會真正關閉連線
哪有什麼方式可以縮短TIME_WAIT的等待時間呢??
方法一.
$> vi /etc/sysctl.conf
## 表示開啟重用機制, 允許socket在TIME_WAIT狀態下, 重新bind新的socket
net.ipv4.tcp_tw_reuse = 1
## 表示開啟回收機制, 允許socket在TIME_WAIT狀態下, 被快速回收, 毋須等待2MSL
net.ipv4.tcp_tw_recycle = 1
$> /sbin/sysctl -p ## 使上述設定生效
方法二.
## 查看系統預設TIME_WAIT時間
$> more /proc/sys/net/ipv4/tcp_fin_timeout
## 修改系統預設TIME_WAIT時間
$> echo 30 > /proc/sys/net/ipv4/tcp_fin_timeout
方法三.
在setsockopt()時, 設置SO_LINGER之屬性,
linger.l_onoff 表示開啟延遲功能
linger.l_linger 表示延遲時間為0秒
struct linger opt_linger = { 0,0 };
opt_linger.l_onoff = 1;
opt_linger.l_linger = 0;
if (::setsockopt(SSock, SOL_SOCKET, SO_LINGER, (const char *)&opt_linger, sizeof(linger)) == -1) {
ap_log (ERROR, "setsockopt(LINGER) fail");
return false;
}
2009年8月26日 星期三
如何防止彊屍程序(zombie)的產生??
當執行program ex1程式片段後, 試著以kill prog1的方式終止prog1之程序,
結果查詢目前各程序執行狀況(ps -ef), 發現出現[prog1],
接下來無論怎麼kill prog1, 都無法將其消滅, 唯有中止main(), 它才會消失...
原來它就是僵屍程序(zombie), 何謂僵屍程序呢??
補救辦法是殺死僵屍程序的父程序(僵屍程序的父程序必然存在),
僵屍程序成為"孤兒程序",過繼給pid=1的程序init,init始終會自行負責清理僵屍進程。
僵屍程序之範例:
解決一.
在父程序設置SIGCHLD信號的處理函式, 使其父程序自動忽略子程序的狀態變更,
但長期常駐程式, 可能不適用, 難保不會出現系統資源耗用的現象
解決二.
在父程序設置SIGCHLD信號的處理函式, 並呼叫waitpid(), 等待捕獲子程序的返回狀態
解決三.
呼叫2次fork(), 父程序呼叫fork(第一次)產生子程序, 子程序再呼叫fork(第二次)產生孫程序,
隨即子程序終結死亡, 此時孫程序變為"孤兒程序",init程序會接管孫程序, 變成它的父程序,
而init程序會自行負責處理SIGCHLD信號
結果查詢目前各程序執行狀況(ps -ef), 發現出現[prog1]
接下來無論怎麼kill prog1, 都無法將其消滅, 唯有中止main(), 它才會消失...
原來它就是僵屍程序(zombie), 何謂僵屍程序呢??
在fork()/execve()過程中,假設子程序結束時父程序仍存在,
而父程序fork()之前既沒設置SIGCHLD信號處理函數調用waitpid()等待子進程結束,
又沒有設置忽略該信號,則子程序成為僵屍程序,無法正常結束,
即使是root身份kill -9也不能殺死僵屍程序。
補救辦法是殺死僵屍程序的父程序(僵屍程序的父程序必然存在),
僵屍程序成為"孤兒程序",過繼給pid=1的程序init,init始終會自行負責清理僵屍進程。
僵屍程序之範例:
int main (int argc, char *argv[])
{
    char *prog_list = {"prog1","prog2", "prog3"};

    for (int i=0; i<3; i++) {
        char *arg_list = {prog_list[i], NULL};
        forkExecProc (prog_list[i], arg_list);
    }

    while (true) {
        sleep (2);
    }

    return 0;
}

int forkExecProc (char *prog, char **arg_list)
{
    pid_t child;

    /* check if fork fail that first child is not created */
    if ((child = fork ())< 0) {
        fprintf (stderr, "fork error");
    } else if (child == 0) {        /* run into first child */
        fprintf (stdout, "fork to execute : [%s]\n", arg_list);
        /* replaces the current process image with a new process image */
        execvp(prog, arg_list);

        /* if execvp() is return, mean that on error */
        fprintf(stderr, "execvp error");
        exit(0);
    }

    return child;
}
解決一.
在父程序設置SIGCHLD信號的處理函式, 使其父程序自動忽略子程序的狀態變更,
但長期常駐程式, 可能不適用, 難保不會出現系統資源耗用的現象
int main (int argc, char *argv[])
{
    signal (SIGCHLD,SIG_IGN); //設置SIGCHLD
    char *prog_list = {"prog1","prog2", "prog3"};

    for (int i=0; i<3; i++) {
        char *arg_list = {prog_list[i], NULL};
        forkExecProc (prog_list[i], arg_list);
    }

    while (true) {
        sleep (2);
    }
    return 0;
}
int forkExecProc (char *prog, char **arg_list)
{
    ...
}
解決二.
在父程序設置SIGCHLD信號的處理函式, 並呼叫waitpid(), 等待捕獲子程序的返回狀態
void sig_fork(int signo)
{
    pid_t pid;
    int stat;
    // 呼叫waitpid(),等待子程序返回, 若無子程序返回, 也不一直等待
    pid=waitpid(0,&stat,WNOHANG);

    return;
}


int main (int argc, char *argv[])
{
    signal (SIGCHLD, sig_fork); // 設置SIGCHLD, 並呼叫waitpid(), 捕獲子程序的返回狀態

    char *prog_list = {"prog1","prog2", "prog3"};

    ...

    return 0;
}


int forkExecProc (char *prog, char **arg_list)
{
    pid_t child;

    /* check if fork fail that first child is not created */
    if ((child = fork ())< 0) {
        fprintf (stderr, "fork error");
    } else if (child == 0) {        /* run into first child */
        fprintf (stdout, "fork to execute : [%s]\n", arg_list);
        /* replaces the current process image with a new process image */
        execvp(prog, arg_list);

        /* if execvp() is return, mean that on error */
        fprintf(stderr, "execvp error");
        exit(0);
    }

    /* no block to wait for first child chang state */
    /* must be use signal (SIGCHLD, xxx) to fetch child change state */
    waitpid (-1, NULL, WNOHANG); // 父程序呼叫waitpid(),不阻塞等待子程序的返回狀態, 待引發SIGCHLD

    return child;
}
解決三.
呼叫2次fork(), 父程序呼叫fork(第一次)產生子程序, 子程序再呼叫fork(第二次)產生孫程序,
隨即子程序終結死亡, 此時孫程序變為"孤兒程序",init程序會接管孫程序, 變成它的父程序,
而init程序會自行負責處理SIGCHLD信號
int main (int argc, char *argv[])
{
    char *prog_list = {"prog1","prog2", "prog3"};

    for (int i=0; i<3; i++) {
        char *arg_list = {prog_list[i], NULL};
        forkExecProc (prog_list[i], arg_list);
    }

    while (true) {
        sleep (2);
    }

    return 0;
}

int TaskHandler::forkExecProc (char *prog, char **arg_list)
{
    pid_t child;

    /* check if fork fail that first child is not created */
    if ((child = fork ())< 0) { // 產生子程序
        fprintf (stderr, "fork error");
    } else if (child == 0) {        /* run into first child */

        /* check if fork fail that second child is not created */
        if ((child = fork ())< 0) { // 產生孫程序
            fprintf (stderr, "fork error");
        }
        else if (child > 0) {       /* run into parent of second child whick is first child */
            /* terminate the first child, in order that second child's parent becomes init */
            exit(0); // 子程序自行終結, 此時孫程序被init接管為它的父程序
        }
        else {                      /* run into second child */
            // 孫程序繼續執行下列步驟
            fprintf (stdout, "fork to execute : [%s]\n", arg_list);
            /* replaces the current process image with a new process image */
            execvp(prog, arg_list);

            /* if execvp() is return, mean that on error */
            fprintf(stderr, "execvp error");
            exit(0);
        }
    }

    /* wait for first child chang status */
    waitpid (child, NULL, 0); // 父程序呼叫waitpid(), 等待子程序終結,並捕獲返回狀態

    return child;
}
2009年7月5日 星期日
dblink of postgresql
現今在承接南部第一大鋼鐵廠的資訊系統工程後, 遭遇到必須連線至遠端的postgresql,
擷取所需的資料, 並不透過Tcp/Ip Socket進行訊息封包的傳送
便回想當初在第一家電子公司當小小MIS, 便曾使用過Oracle其一功能, 簡稱db link,
不必在ap上, 另外多建立一個資料庫連線, 可利用原資料庫連線擷取另遠端資料庫的功能
於是上網google, 果不其然postgresql也支援著類似的功能, 不愧是自由軟體界資料庫第一把交椅,
而安裝動作也很簡單, 整理如下所述:
## 安裝 (至存放原始安裝檔之路徑)
$> cd contrib/dblink
$> make
$> make install
## dblink相關函式安裝 (至postgresql安裝目錄之路徑)
## 此時會新增兩個檔案 pgsql/lib/dblink.so(函式庫) & pgsql/share/contrib/dblink.sql(語法安裝)
$> su - postgres
$> cat dblink.sql psql
參考網址: db link sql
2009年5月23日 星期六
Difference between Big Endian and Little Endian
Difference between Big Endian and Little Endian
原文釋意:
"Little Endian" means that the low-order byte of the number is stored in memory at the lowest address, and the high-order byte at the highest address. (The little end comes first address.)
"Big Endian" means that the high-order byte of the number is stored in memory at the lowest address, and the low-order byte at the highest address. (The big end comes first address.)
中文釋意:
為什麼叫『大頭』派?因為電腦把『大』的位數放在『前面』 (記憶體編號小的就是前面)。就好像我們寫十進制數字 123 的意思一百二十三 (100 + 20 + 3),也就是最大位--百位,寫在前面。
相反地,如果把『小』的位數放在『前面』,那就是『小頭』派了。如果有一個民族的文字,把 123 解釋成三百二十一 (1 + 20 + 300),那他們就是『小頭派』。
阿拉伯文的文字書寫,是從右向左橫寫,但是遇到數字的時候,卻是跟我們一樣從左向右寫。如果阿拉伯人讀文字與數字的時候,都是從右向左讀,則他們會先讀到數字的最小位。在這個意義之下,阿拉伯人是『小頭派』。
int i = 2562 + 2x256 + 3 = 00000000 00000001 00000010 00000011 位元排列方式 = 0 1 2 3 無號整數方式
CPU 一定會配給連續四個記憶體給 i,但是這四個記憶體,卻有兩種放置四個 byte 的可能順序。如果我們一律按照記憶體位址從小到大的順序來講,則四個記憶體放置的字元可能是先 00000000 然後 00000001 然後 00000010 最後 00000011
Lo-------------->Hi (Big Endian)
+-+-+-+-+-+-+-+-+-
00 01 02 03
+-+-+-+-+-+-+-+-+-
Hi<--------------Lo (Little Endian)
2009年4月22日 星期三
How to read .ini file by using glib
在Windows API中, 提供相當方便的函式庫, 可以簡單地讀取.ini檔案,
但在c++ standard library中, 卻不見著任何蹤跡,雖說自己很喜歡coding, "蛋"不是這麼搞的啦!!
google search提供了一個相當不錯的工具 -- glib
不免俗地要介紹一下本文主角- glib 。
gnome是基於gtk+開發的一套桌面環境,gnome和KDE作為兩大最流行的桌面環境,在全世界廣泛使用。 只要是在Linux下工作的開發人員,對於gtk+一定不陌生。 而對於glib,這個gtk+下的無名英雄,其功能強大卻鮮為人知。
glib不是glibc,儘管兩者都是基於GPL的開源軟體。但這一字之差卻誤之千里,glibc是GNU實現的一套標準C的庫函數,而glib是gtk+的一套函數庫。
在linux平臺上,像其他任何軟體一樣,glib依賴於glibc。glib不是一個學院派的東西,也不是憑空想出來的,完全是在開發gtk+的過程中,慢慢總結和完善的結果。
如果你是一個工作3年以上的C語言程式師,現在讓你講講寫程式的苦惱,你可能有很多話要說,但如果你有時間研究一下glib,你會發現,很多苦惱已不再成其為苦惱,glib裏很多東西正是你期望已經久的。
gobject是glib的精粹,glib是用C實現的,但在很大程式是基於面向物件思想設計的,gobject是所有類的基類。signal在其中也是一大特色,signal與作業系統中的signal並不一樣,它是類似消息一樣的東西,讓消息在各個物件間傳遞,但儘量降低物件間的耦合。
1. setup the glib
$> ./configure2. include glib header files and library to compile
$> make
$> make install
##顯示glib include的路徑
$> pkg-config --cflags glib-2.0
-I/usr/include/glib-2.0 -I/usr/lib/glib-2.0/include
##顯示glib library的路徑
$> pkg-config --libs glib-2.0
-L/usr/lib -lm -lglib-.20
並在程式的標頭檔加入下列文字
#include "glib.h"
完成上述兩個簡單的步驟, 就可以親身去體會glib的強大之處囉!!
參考來源::
GLib Reference ManualWiki GLib
2009年4月14日 星期二
指標的指標 (pointer to pointer)
int **iptr;
上面是宣告了一個指標指向另一int的指標, 很饒舌對吧!簡單說, 就是指標的指標 (pointer to pointer)
何以需要這樣的用法?在網路上拜讀了某位前輩的文章的範例, 突然間茅塞頓開...
上述例子, 印出來的數值仍為1, 因為changePtr的pInt是localPtr的複本, 對pInt做變更, 其實並不會影響到localPtr本身
使用call by pointer (or address)來傳遞參數, 被呼叫的函式只是複製pointer的值過去罷了!
所以當我們想在函式內改變外來的pointer的值(非pointer所指向的變數), 且函式外部能使用其改變的pointer的值, 此刻就是call by pointer to pointer登場的最佳機會!
下述例子, 印出來的數值變為gint的0, changePtr()的pInt是&localPtr的複本, 對其做任何變更, 並不會去影響到localPtr本身, 但在changePtr(), 我們是對pInt所指向的內容(就是localPtr)做變更, 由原本存放local_int的address, 變更為存放gind的address
上面是宣告了一個指標指向另一int的指標, 很饒舌對吧!簡單說, 就是指標的指標 (pointer to pointer)
何以需要這樣的用法?在網路上拜讀了某位前輩的文章的範例, 突然間茅塞頓開...
int gint = 0;
void changePtr (int *pInt)
{
    pInt = &gint;
}
void main ()
{
    int local_int = 1;
    int *localPtr = &local_int;
    changePtr (localPtr);
    printf ("%d\n", *localPtr);
}
上述例子, 印出來的數值仍為1, 因為changePtr的pInt是localPtr的複本, 對pInt做變更, 其實並不會影響到localPtr本身
使用call by pointer (or address)來傳遞參數, 被呼叫的函式只是複製pointer的值過去罷了!
所以當我們想在函式內改變外來的pointer的值(非pointer所指向的變數), 且函式外部能使用其改變的pointer的值, 此刻就是call by pointer to pointer登場的最佳機會!
下述例子, 印出來的數值變為gint的0, changePtr()的pInt是&localPtr的複本, 對其做任何變更, 並不會去影響到localPtr本身, 但在changePtr(), 我們是對pInt所指向的內容(就是localPtr)做變更, 由原本存放local_int的address, 變更為存放gind的address
int gint = 0;
void changePtr (int **pInt)
{
    *pInt = &gint;
}
void main ()
{
    int local_int = 1;
    int *localPtr = &local_int;
    changePtr (&localPtr);
    printf ("%d\n", *localPtr);
}
訂閱:
文章 (Atom)